

把飞牛 NAS 变成一台音箱:FnSpeaker 开发记录
家里的飞牛 NAS 一直只当存储用,直到某天我想在厨房做饭时听点东西——手机放在客厅,声音得跟过来。市面上的方案要么买硬件音箱,要么装一堆服务,都不太对味。
最后我干脆自己写了一个:把 NAS 变成一台音箱。手机用蓝牙或者 DLNA 把音频推过来,NAS 用自带的声卡放出来。
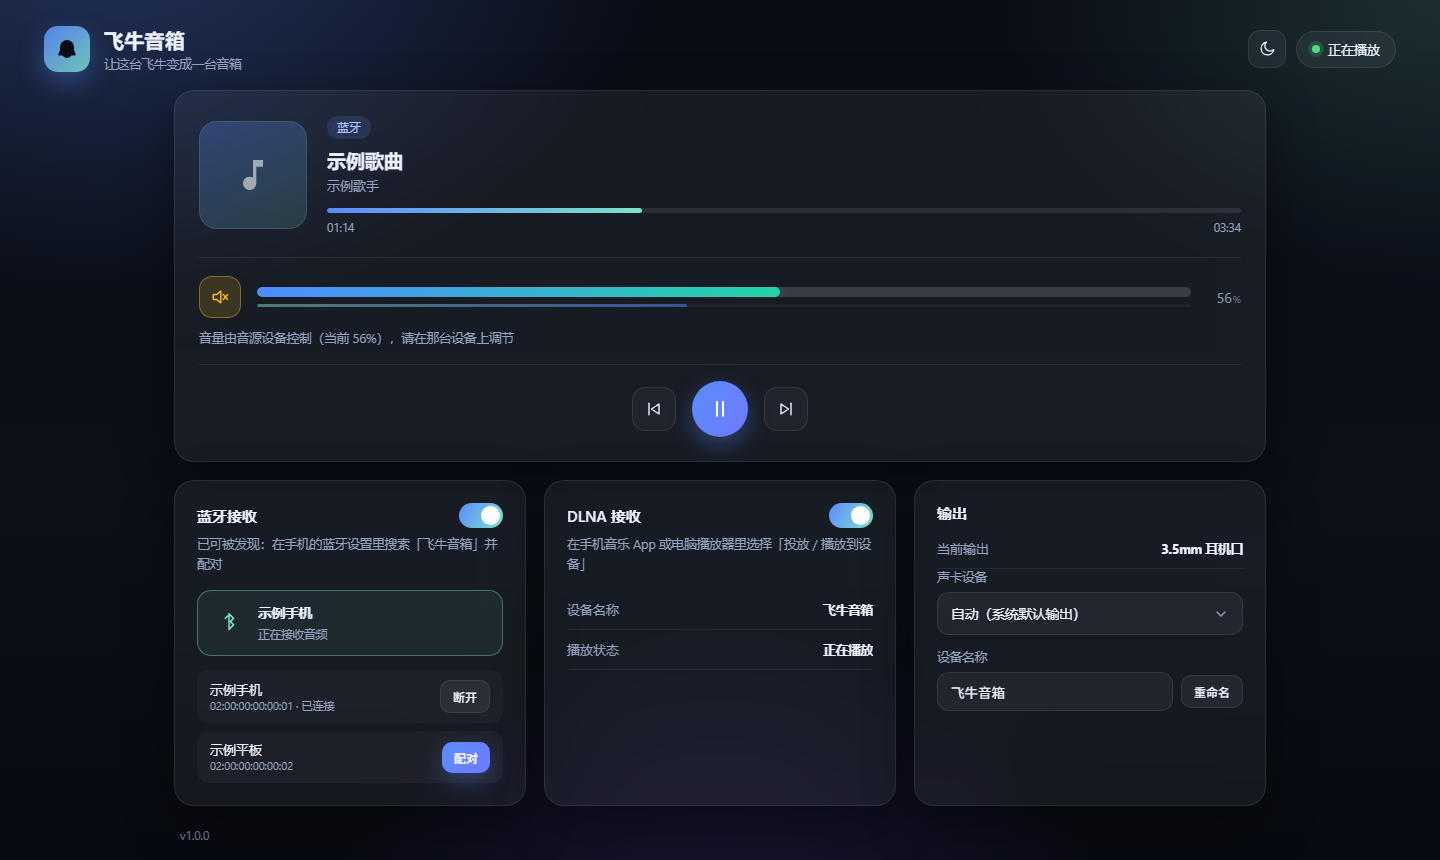
成品叫 FnSpeaker(飞牛音箱),已经开源在 GitHub,装完是这样:
这篇文章不写"如何使用",而是记录开发过程中真正卡住我的七个问题,以及每个问题最后是怎么定位的。如果你也在做 Linux 音频、UPnP 或 BlueZ 相关的东西,应该能省下不少时间。
一、整体架构
先说结论:这个项目没有引入任何第三方运行时依赖。
手机 ──DLNA(SSDP+SOAP)──┐
                        ├──► Python 后端 ──► ALSA ──► 声卡
手机 ──蓝牙 A2DP────────┘        │
                                └──► Web UI(原生 JS)
几个关键选择:
| 选择 | 原因 |
|---|---|
Python 标准库 http.server | 界面走飞牛的 Unix Socket 网关,不需要 ASGI 那一套 |
ctypes 直调 libasound.so.2 | 机器上没有 PulseAudio / PipeWire,只能直接对 ALSA 说话 |
| 原生 JS,零框架 | 页面只有三个文件,加载快、也不用担心外网 CDN 被墙 |
| 自己实现 SSDP / SOAP / GENA | 只为做一个渲染器,引整套 UPnP 库太重 |
运行环境:Surface Pro 7 / fnOS 1.2.1000(Debian 12 内核 6.18)/ Realtek ALC274 / Intel AX201 / BlueZ 5.66 + BlueALSA 4.0.0 / Python 3.11。
二、坑一:装完完全没有声音
代码跑起来了,界面也正常,就是一点声音都没有。
第一反应是音量问题,查了才发现有两个叠加的原因:
原因 1:DAC 音量开机是 0
这台机器没有声音服务,所以没人去初始化混音器。/proc/asound/card0/codec#0 里 DAC 的 Amp-Out vals 是 [0x00 0x00]——音量真的是 0。
解法是启动时用 mixer API 把所有 playback 控件拉满并解除静音:
snd_mixer_selem_set_playback_volume(elem, 0, max_value)
snd_mixer_selem_set_playback_switch(elem, 0, 1)
原因 2:内核把输出路由到了耳机口
混音器修好之后还是没声音。再看 codec:
Node 0x1b (内置喇叭)  Pin-ctls: 0x00: VREF_HIZ   ← 关闭
Node 0x21 (耳机口)    Pin-ctls: 0xc0: OUT HP     ← 打开
内核默认把输出指到了耳机口,而我没插耳机。需要在 HDA 层面直接改引脚状态,也就是对 /dev/snd/hwC0D0 发 ioctl:
HDA_IOCTL_VERB_WRITE = 0xC0084811
SET_PIN_WIDGET_CONTROL = 0x707

buf = struct.pack("II", (nid << 24) | (verb << 8) | param, 0)
fcntl.ioctl(fd, HDA_IOCTL_VERB_WRITE, buf)两个原因都解决后才有声音。这也是我第一次意识到:在没有声音服务的机器上,"能不能出声"完全取决于你自己有没有把硬件状态摆对。
三、坑二:切换输出设备时进程直接退出
界面里加了个输出设备下拉框,结果一选就崩,进程直接没了。
原因是并发:写线程正在 snd_pcm_writei 里,主线程把 PCM 句柄关了,于是段错误。
修法很朴素——把打开、写入、关闭整段用可重入锁包起来:
self._lock = threading.RLock()

with self._lock:
    pcm = self._ensure_pcm(rate, channels)
    pcm.write(data)
这类问题在 C 绑定里特别常见:Python 层看起来是"顺序执行",但 ctypes 调用期间 GIL 可能被释放,别的线程就进来了。
四、坑三:DLNA 死活搜不到设备
这是最离谱的一个。DLNA 服务在跑,dd.xml 也能打开,但手机和电脑的投送入口里就是看不到设备。
我写了个脚本直接发 M-SEARCH,才看清问题:
客户端: M-SEARCH  ST: ssdp:all
我的响应: ST: ssdp:all        ← 就是这里
UPnP 规范要求:对 ssdp:all 的搜索,必须按自己支持的每个 NT/ST 各回一条,ST 字段只能是具体类型(upnp:rootdevice / uuid:xxx / urn:...:device:MediaRenderer:1 / 各个 service 类型),绝不能是 ssdp:all。
我原来只回了一条 ST: ssdp:all 的响应——大部分客户端看到这个不认识的 ST,直接就丢弃了。
除此之外还有两个次要问题:
- 只匹配了
MediaRenderer,客户端搜AVTransport服务类型时完全不回应 - 上线通告(
NOTIFY ssdp:alive)只在启动时发一次,丢包之后就再也发现不了
修完之后的验证结果:
=== ssdp:all ===
  ST=upnp:rootdevice                      LOCATION=http://…/dd.xml
  ST=uuid:fnspeaker-…                     LOCATION=http://…/dd.xml
  ST=urn:schemas-upnp-org:device:MediaRenderer:1   …
  ST=urn:schemas-upnp-org:service:AVTransport:1    …
  ST=urn:schemas-upnp-org:service:RenderingControl:1 …
  ST=urn:schemas-upnp-org:service:ConnectionManager:1 …
共 6 条还有个小细节:这台机器有两张同网段的网卡(有线 + WiFi)。如果 LOCATION 固定写有线地址,WiFi 侧的客户端可能拿到一个不可达的 URL。所以要用 IP_PKTINFO 取请求实际进入的那张网卡:
sock.setsockopt(socket.IPPROTO_IP, socket.IP_PKTINFO, 1)
data, ancdata, flags, addr = sock.recvmsg(2048, socket.CMSG_SPACE(12))
# cdata[8:12] 就是目的地址
五、坑四:播放断断续续,CPU 却不高
蓝牙放歌时声音一顿一顿的。第一反应是 CPU 不够,但 top 显示总负载才 1.5。
真正的原因在 dbus-daemon:它吃了 52% 的 CPU。
我用 SIGSTOP 冻住自己的应用做了个对照:
| 状态 | dbus-daemon CPU |
|---|---|
| 应用运行 | 53% |
| 应用冻结 | 0% |
| 应用恢复 | 52% |
100% 的总线压力都来自我自己。再给计数器打上标签,直接点名:
6 秒内启动 152 次子进程
  bluetoothctl devices   147   ← 就是它
busctl --system 3原来采集循环里,每读一个音频分片都要查一次"当前连了哪些设备",而那个函数没有缓存。48kHz 下每秒 25 个分片,就是每秒 25 次 bluetoothctl,每个进程都要连一次 D-Bus。
修完之后:
| 指标 | 修复前 | 修复后 |
|---|---|---|
| 子进程启动 | 25.3 次/秒 | 2.2 次/秒 |
| dbus-daemon CPU | 52% | 2% |
顺手还做了几处优化:AVRCP 的四个属性从"四次 get-property"改成"一次 GetAll",播放器对象路径缓存从 8 秒延长到 60 秒。
这条经验值得单独记住:在资源受限的设备上,"每个循环都起一个子进程"是性能杀手,而且它不会体现在自己的 CPU 占用上。
六、坑五:断开重连之后没有声音
现象很迷惑:界面显示正在播放,进度条在走,但一点声音都没有。
查数据才发现关键:
应用侧:   frames 在涨(27.2M → 28.4M),但 level = 0.0   ← 读到的是静音
PCM 属性: Sequence 从 0 变成 1,采样率 48000 → 44100      ← 传输被重建了
新建句柄: 抓到同一路,峰值 7299 ← 音频其实一直在也就是说:音频一直在进来,但我手上的 PCM 句柄连的还是上一次连接的传输,重连后它只会吐零。
修法是让采集循环感知"传输被换掉了":
cur = self.bluealsa_volume()
if open_seq is not None and cur.get("seq") != open_seq:
    pcm.close()          # 关掉重开
    pcm = None
再加一层兜底:连续 3 秒读到全零、且距上次重开超过 10 秒,就强制重开一次。
七、坑六:音量条"调了但数值对不上"
一开始界面上的音量条是可拖的,通过 busctl set-property 写 BlueALSA 的传输音量。用户反馈:高档位总是往下掉。
我写了个脚本逐档测试,结果很夸张:
写入 100% → 回读 100.0%  ✓
写入  95% → 回读  43.5%  ✗  -51.5
写入  90% → 回读  58.8%  ✗  -31.2
写入  70% → 回读  37.3%  ✗  -32.7
写入 50% → 回读 2.4% ✗ -47.6但同一个值连写两次就精确命中(写 20000 第一次回读 12593,第二次回读 20000)。
这说明不是量化误差,而是链路层面首次写入被丢弃。双写确实能修好,但我最终没有采用,而是做了一个更干脆的决定:
把界面音量改成只读。
理由很简单:与其给用户一个"调了不准、高档位还往回掉"的滑块,不如彻底把音量的解释权交给音源设备——手机上的音量同步是什么,这里就显示什么。少一个功能,少一堆不可控。
这个决策后来还引出一个更深的发现:"设备音量同步"这个开关的状态,在协议层根本拿不到。开关本身在数据里不产生任何痕迹,Volume 是满值时既可能是"手机停在 100%",也可能是"手机没在控制"。我把这段完整记录写进了仓库文档,作为后续可能的开发方向(主动探测、读 AVRCP 能力位等),但当前版本就是老老实实只读。
八、坑七:两路音源同时出声
一开始蓝牙和 DLNA 是各放各的,两路都往音频引擎里喂数据,输出就被交替写入,听起来像两个台在打架。
于是加了一层音源仲裁,规则是「后来者优先」:
| 情形 | 结果 |
|---|---|
| 蓝牙在放 → 开始 DLNA 投送 | 手机先暂停,再断开连接;DLNA 立即播放 |
| DLNA 在投 → 蓝牙开始播放 | DLNA 被停止,蓝牙接管 |
| 两台手机先后播放 | 后播放的生效,前一台被断开 |
| 两个投送端先后投放 | 后投放的生效,前一路被停止 |
实现上踩了两个小坑:
坑 A:抢占把请求堵死了。 我一开始在 SOAP 的 Play 处理里同步去查蓝牙设备列表,而那个查询在缓存过期时要起三个子进程、每个最多 8 秒。客户端等超时,以为播放失败,用户就得点第二次播放。
改成全部丢到后台线程、仲裁状态先落定再异步踢人之后:
发一次 Play → 耗时 0.005s HTTP 200坑 B:只断链路,手机继续外放。 只断开 A2DP 连接的话,手机音乐 App 会转回手机扬声器接着放,用户看到的是"根本没停"。所以断开前要先发一条 AVRCP Pause:
if _bt.streaming:
    _bt.media("pause")   # 先让手机自己暂停
    time.sleep(0.3)
_bt.disconnect(mac) # 再断连接还有一个不得不加的东西:20 秒冷却。
因为手机被断开后会自动重连、投送端失败后会自动重试,两边就会无限互踢。测试日志里看得很清楚:
03:38:19 蓝牙让位(DLNA 开始投放):断开 …
03:38:20 蓝牙抢占:停止当前的 DLNA 投放
03:38:28 当前音源:DLNA
所以被让位的设备在 20 秒内重新连上不会立刻抢回(会被再次断开)。代价是想切回来得等约 20 秒,这一点我在 README 和使用说明里都写明了——这种"看起来像 bug 的设计",必须在文档里主动交代清楚。
九、还有一堆小事
除了上面七个大坑,还有不少零碎的:
- 蓝牙配对失败:
bluetoothctl的 agent 在等键盘输入Confirm passkey (yes/no),没人应答就超时。换成NoInputNoOutput并自动回yes才通。 - 蓝牙 3 分钟后搜不到:BlueZ 默认
DiscoverableTimeout=180,设成 0 才行。 - 图标不显示:
ui/config里声明的是images/icon_{0}.png,但包里根本没有这个目录,飞牛只能用占位图。补上图标生成和/images/*路由之后,桌面和窗口图标才正常。 - 跨设备适配:一开始把声卡编号和引脚号写死(
hwC0D0、NID0x1b/0x21),换台机器就废。后来改成从/proc/asound/card/codec#解析Pin Default里的[Fixed] Speaker at Int和[Jack] HP Out,解析不到就自动隐藏"喇叭/耳机"选项。 audioop在 Python 3.13 被移除:写了层兼容模块,有audioop用 C 实现,没有就用array做定点运算,行为完全一致。
十、成品
界面长这样(深色 / 浅色,跟随系统,可手动切换):
功能上:
- DLNA 投送接收(标准 MediaRenderer,SSDP 合规)
- 蓝牙 A2DP 接收 + AVRCP 曲目信息与播放控制
- 输出设备可切换(内置喇叭 / 耳机口 / HDMI / 其他声卡),耳机插拔自动跟随
- 音源互斥 + 冷却
- 深浅两套主题
安装包按架构分两个(x86 / arm),在 Releases 下载,飞牛应用中心手动安装即可。
十一、几点感想
第一,嵌入式/低配环境里,"能不能用"往往卡在状态初始化上。 没声音不是代码写错,而是 DAC 音量为 0、引脚路由到耳机口——这些东西平时被声音服务替你做了,一旦没有服务,就全得自己来。
第二,协议实现要按规范写,不能"看起来能用"。 ST: ssdp:all 这个响应在我自己的测试里是"有回应"的,但规范不允许,客户端就是会丢弃。用自己的脚本验证时,要按规范验证,而不是按"有没有回包"验证。
第三,性能问题未必体现在自己的进程上。 每秒 25 次子进程,把我自己的 CPU 压得不高,却把系统总线打到 52%,最后表现成音频卡顿。SIGSTOP 对照法在这种情况下特别好用。
第四,功能做不出来时,"不做"也是一种正确答案。 音量那条路我试了四五个版本:阈值判定、时间宽限、粘性判定、实时判定……每个都能说通,每个都出错。最后改成只读,反而稳定了。当一个问题反复失败,先怀疑前提是不是错的,而不是继续加补丁。
第五,文档里要主动写"看起来像 bug 的设计"。 20 秒冷却、音量只读、DLNA 不能切歌——这三件事如果不写清楚,用户百分百会当成缺陷来报。
项目地址:<https://github.com/YunJian101/FnSpeaker>(GPL-3.0)
个人自用项目,按现状开源,不保证适配所有硬件与系统版本。如果它恰好也能帮你把闲置的 NAS 用起来,那就太好了。
- 感谢你赐予我前进的力量
-
 微信
 支付宝
